
A marzo 2026 il brand non compariva in nessuna delle 755 risposte analizzate. Quattro mesi dopo l’avvio del progetto è il terzo nome più citato del suo mercato.
- 3º — fra i brand citati dagli assistenti nel suo mercato, da una posizione di sostanziale assenza
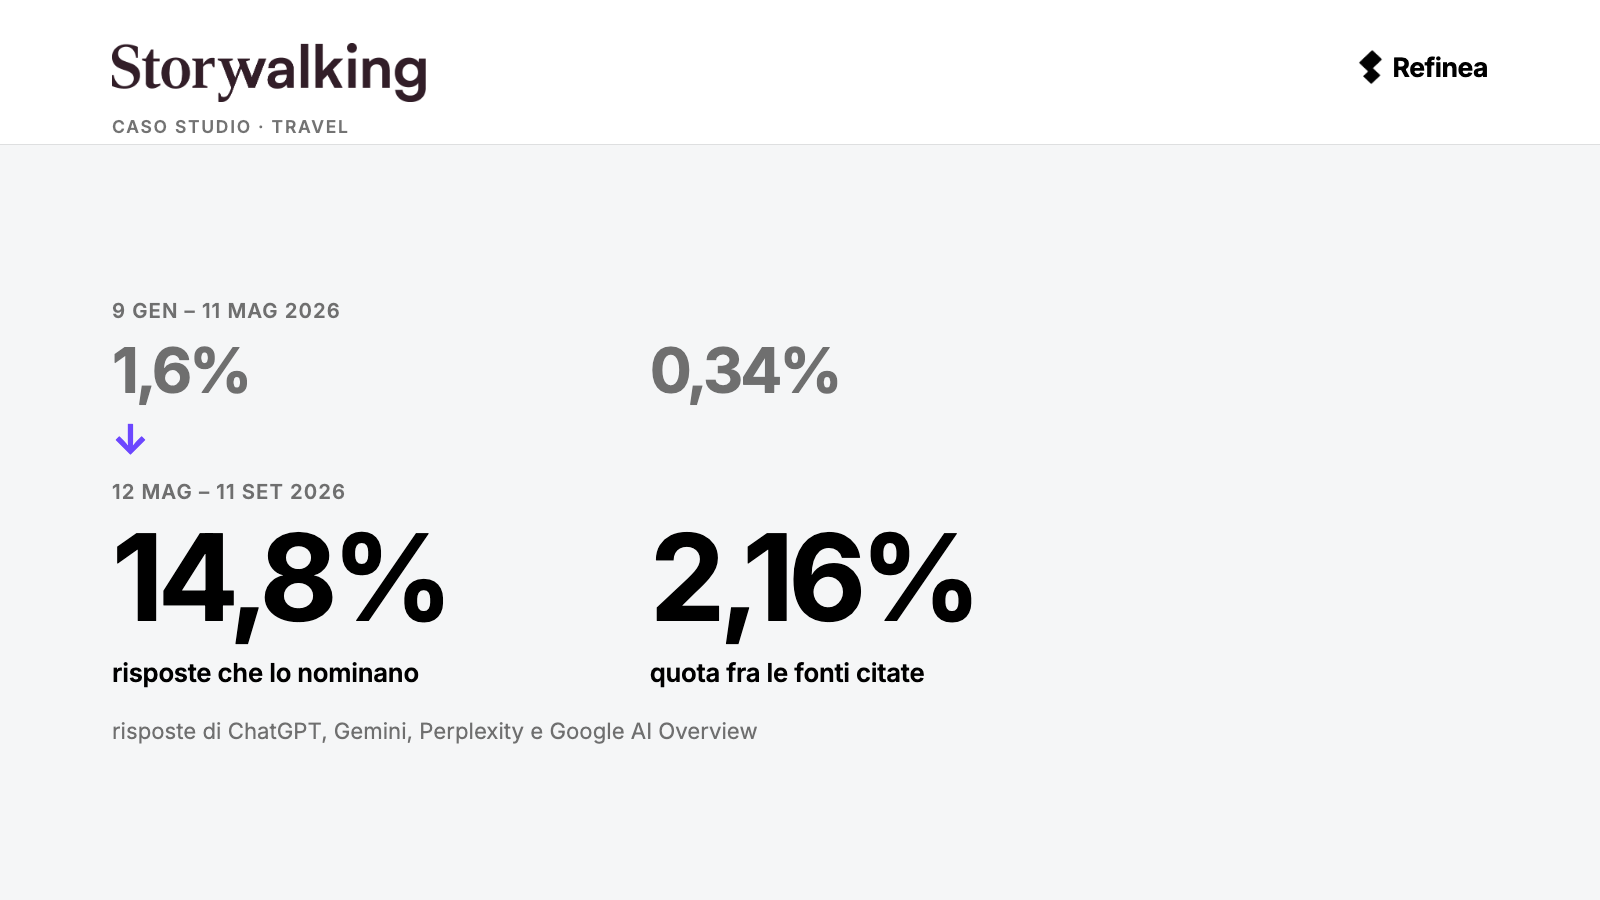
- 1,6% → 14,8% — risposte degli assistenti che nominano il brand
- 1 giorno — fra la pubblicazione di un articolo e la sua prima citazione
Il punto di partenza
Storywalking è un tour operator italiano che costruisce viaggi culturali su misura per un pubblico internazionale. Compete con operatori che hanno decenni di storia, redazioni interne e budget che una realtà di questa dimensione non può avvicinare.
Nei 123 giorni precedenti l’avvio del progetto la piattaforma aveva già analizzato 6.410 risposte: il brand veniva nominato nell’1,6% dei casi, il suo sito compariva nello 0,34% delle fonti citate, e nella classifica del mercato non entrava nemmeno fra i primi cento marchi. Per un assistente AI, in pratica, non esisteva.
Perché un confronto viene citato e una pagina di servizio no
Storywalking ha smesso di scrivere della propria offerta e ha iniziato a pubblicare confronti fra operatori: «le migliori compagnie per viaggiare in Italia», «i migliori tour di immersione culturale». Detta così è una mossa vecchia, e chi fa questo mestiere la conosce da vent’anni. Quello che è cambiato è il motivo per cui funziona.
Un assistente che riceve «a chi mi rivolgo per un viaggio culturale in Italia» non cerca quella frase. La scompone in ricerche più piccole, e parecchie di quelle sono già formulate come confronti. Una pagina che è essa stessa un elenco ragionato di operatori non ha bisogno di essere interpretata: i nomi sono già estratti, già ordinati, già motivati. Combacia con la forma della risposta, non solo con il suo argomento.
Le domande di partenza non sono state scelte a intuito: vengono da quelle che il monitoraggio registra ogni giorno sul mercato, e ogni articolo dichiara a quali deve rispondere.
La parte scomoda è che un confronto del genere nomina anche i concorrenti, e li nomina su un dominio che è tuo. Il rischio è dare visibilità a loro. Il ritorno è che la pagina diventa la fonte che il modello apre, e chi l’ha scritta è dentro l’elenco invece di essere fuori dalla risposta.
L’articolo pubblicato il 2 luglio alle 9:55 è stato citato da un assistente AI il 3 luglio. Nelle settimane successive quella pagina è comparsa nel 12–16% di tutte le risposte di Gemini sul mercato, ed è arrivata a 288 citazioni.
Va detta anche la controindicazione: la prima pagina della serie, da sola, vale il 54% di tutte le citazioni che il sito riceve. È un risultato e insieme una concentrazione, perché finché regge quella regge tutto il resto. È anche il motivo per cui una serie di pezzi regge meglio di un pezzo solo.
Prima e dopo, a parità di durata
Quattro mesi di progetto contro i quattro mesi immediatamente precedenti: 123 giorni per parte, le stesse domande, gli stessi motori.
| 9 gen – 11 mag 2026 | 12 mag – 11 set 2026 | |
|---|---|---|
| Risposte che nominano il brand | 1,6% | 14,8% |
| Quota di voce nel mercato | 0,2% | 2,0% |
| Posizione fra i brand citati | fuori dai primi cento | 3º su 1.054 |
| Quota fra le fonti citate | 0,34% | 2,16% |
| Citazioni ricevute dal sito | 69 | 2.298 |
E quando compare, compare in alto: la posizione media nelle risposte che lo nominano è 4,0.
Come nasce un contenuto che i modelli citano
La scaletta viene dal query fan-out. Quando un assistente riceve una domanda non cerca quella domanda: la scompone in decine di ricerche più piccole, e su quelle costruisce la risposta. Quelle ricerche sono il query fan-out, ed è la cosa più vicina che esista a «cosa cerca il modello mentre risponde». Refinea le registra a ogni rilevazione e l’agente che scrive gli articoli le usa come struttura: il pezzo non viene scritto a intuito e poi ottimizzato, viene costruito dall’inizio sulla forma della risposta.
E parla come il brand. L’articolo è stato scritto a partire dal brand kit che Storywalking ha caricato in piattaforma — il suo posizionamento, il suo tono, le sue parole. Così il contenuto che i modelli citano è riconoscibilmente suo, e non un testo intercambiabile con quello di qualsiasi altro operatore.
Come sono misurati questi numeri
Domande reali del mercato in inglese, spagnolo e portoghese — le lingue del pubblico del cliente — poste ogni giorno a quattro assistenti AI: 6.410 risposte analizzate nei 123 giorni precedenti l’avvio, 9.051 nei 123 successivi. «Risposte che nominano il brand» è la quota di risposte in cui il nome compare; la classifica confronta il brand con ogni altro marchio che appare nelle stesse risposte; la quota di una fonte è la media delle quote presso i singoli motori, così un modello che restituisce elenchi più lunghi non pesa più degli altri. Ogni confronto è fra il periodo di progetto e il periodo immediatamente precedente di pari durata.
Non serve essere i più grandi. Serve essere quelli che il modello trova.
Refinea ti dice quali domande contano nel tuo mercato, chi viene nominato oggi al posto tuo, e quali contenuti cambiano la risposta.